
Panduan Lapangan Insinyur untuk Pemeliharaan Prediktif Sistem PLC dan SCADA
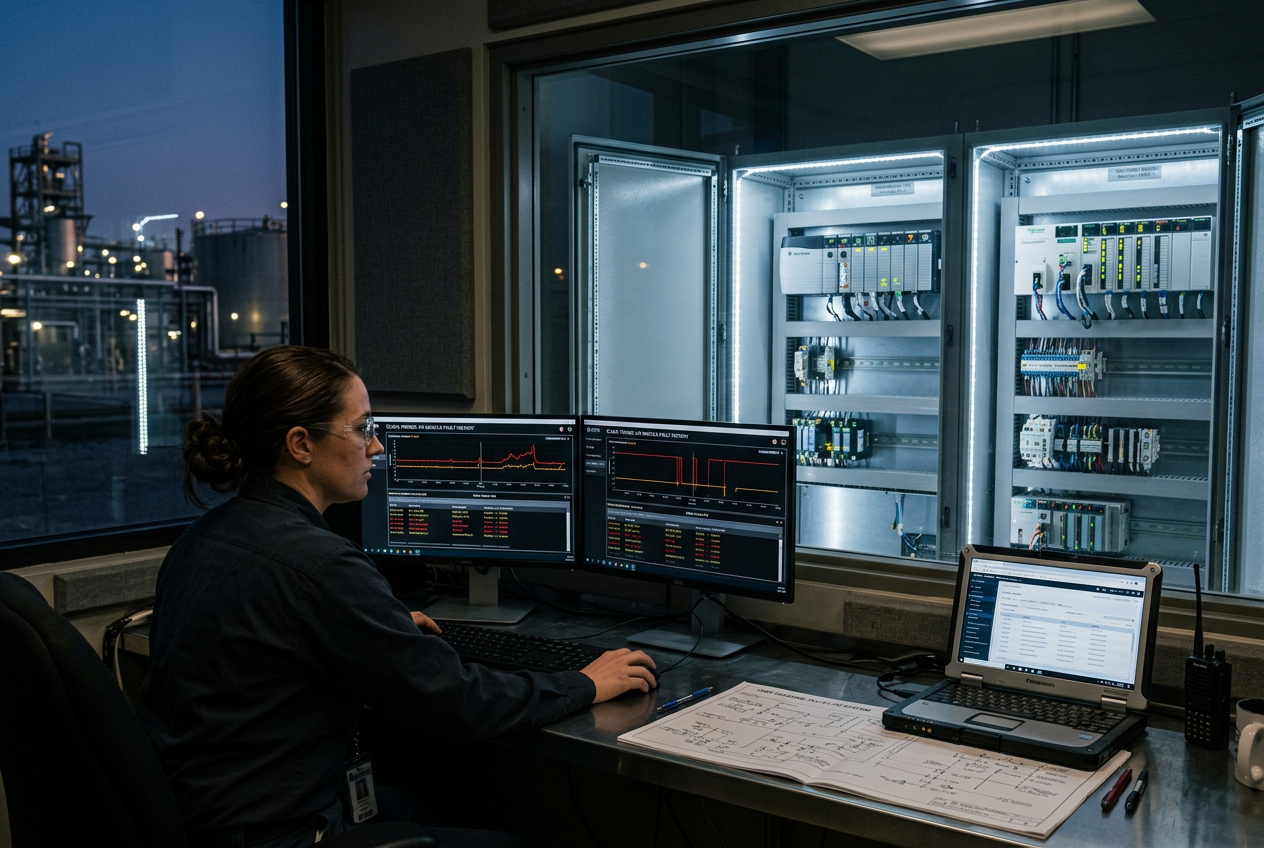
Di fasilitas industri modern, lapisan otomasi jarang mengalami kegagalan fatal tanpa peringatan. Modul I/O mungkin sesekali offline sekali seminggu, atau koneksi komunikasi jarak jauh mengalami timeout dua kali setiap shift. Produksi tetap berjalan tanpa gangguan, tetapi sinyal peringatan kritis diam-diam menumpuk di buffer diagnostik. Alih-alih menerapkan jaringan sensor getaran atau suhu tambahan yang mahal, pemeliharaan prediktif yang efektif dimulai dengan secara aktif memantau data diagnostik yang sudah dipublikasikan oleh pengontrol dan bridge komunikasi Anda.
Mengapa pemeliharaan prediktif harus dimulai dari pengontrol PLC yang sudah ada?
Seperti yang baru-baru ini disoroti oleh para pakar industri di InstrumentationTools, register diagnostik PLC dan SCADA berisi tanda-tanda awal kerusakan jauh sebelum kegagalan mekanis terjadi. Pengalaman di lapangan menunjukkan bahwa peralatan otomasi mengalami penurunan kinerja secara perlahan: kehilangan paket secara diam-diam, percobaan ulang, dan kesalahan buffer menumpuk di dalam memori pengontrol. Dengan memanfaatkan metrik internal yang sudah ada ini, Anda dapat melakukan pemantauan kondisi secara langsung tanpa berinvestasi pada instrumentasi sekunder yang redundan.
Bagaimana cara memantau kesehatan EtherNet/IP pada Allen-Bradley ControlLogix?
Arsitektur Allen-Bradley ControlLogix, yang ditenagai pengontrol berperforma tinggi seperti Modul Pengontrol Proses Allen Bradley 1756-L85EP ControlLogix 5580, menyediakan visibilitas diagnostik yang mendalam melalui instruksi GSV (Get System Value) dan antarmuka web bawaan pada modul bridge seperti Modul Bridge Komunikasi EtherNet/IP Allen Bradley 1756-EN2T.
-
Baca word status secara berkala: Jalankan instruksi GSV secara berkala untuk meminta tag
Module:StatusdanModule:FaultInfodengan interval satu menit. - Lacak penghitung koneksi CIP: Gunakan diagnostik web EN2T bawaan untuk mencatat timeout koneksi CIP, dengan fokus pada grup Requested Packet Interval (RPI) tertentu.
- Tandai koneksi yang sering terputus: Tetapkan flag logika ketika koneksi jarak jauh, seperti adaptor Flex I/O atau Point I/O, tersambung kembali lebih dari tiga kali dalam siklus 24 jam.
- Alirkan tag kualitas ke SCADA: Kirim status kualitas perangkat yang dihitung ke historian SCADA bersama tag proses operasional.
Pendekatan ini tidak memerlukan perangkat keras tambahan dan dapat mengidentifikasi switch yang tidak dikelola dan mulai memburuk, kabel patch yang rusak, atau transceiver serat optik yang kinerjanya marginal beberapa minggu sebelum menyebabkan penghentian lini yang tidak terduga.
Bagaimana cara memantau tren kesalahan komunikasi Modbus TCP pada Schneider M340?
Arsitektur Schneider Electric Modicon, termasuk Modul Prosesor Schneider Modicon M340 BMXP342000 yang dipasangkan dengan antarmuka khusus seperti Modul Komunikasi Ethernet Schneider BMXNOC0401 M340, mencatat statistik kesehatan komunikasi terperinci untuk setiap kanal dalam Unity Pro / EcoStruxure Control Expert.
-
Polling word sistem: Lakukan polling terhadap register status komunikasi internal
%SWdan penghitung kesalahan kanal dengan interval lima menit ke historian Anda. - Analisis laju perubahan: Hitung laju kesalahan dari waktu ke waktu, bukan hanya melacak jumlah kumulatif, karena lonjakan laju menunjukkan penurunan kinerja komponen secara akut.
- Lacak kode pengecualian Modbus: Perhatikan respons Exception 03 yang berulang, karena sering menunjukkan ketidaksesuaian register setelah pembaruan firmware perangkat pihak ketiga.
- Korelasikan kesalahan dengan kondisi lingkungan: Buat grafik lonjakan kesalahan komunikasi terhadap suhu lingkungan kabinet dan getaran mesin untuk menemukan terminal kabel yang longgar dengan cepat.
Penyaringan sangat penting: satu pengecualian terisolasi setiap hari merupakan gangguan komunikasi yang normal, sedangkan lima puluh percobaan ulang per jam menunjukkan transceiver lapangan yang rusak atau kejenuhan jaringan.
Bagaimana cara memasukkan peringatan prediktif ke CMMS tanpa menyebabkan kelelahan alarm?
Jika setiap gangguan jaringan sementara menghasilkan tiket pemeliharaan, teknisi pemeliharaan akan segera menjadi tidak peka. Strategi kualifikasi yang disiplin membantu mempertahankan kepercayaan teknisi:
- Wajibkan pengulangan kondisi: Tetapkan ambang pemicu CMMS yang mengharuskan masalah berlangsung terus-menerus, seperti tiga sesi terputus pada satu node dalam 24 jam.
- Perkaya konteks tiket: Tambahkan secara otomatis tag aset tertentu, kode kesalahan diagnostik yang tepat, dan gejala dalam bahasa sederhana ke setiap perintah kerja.
- Pisahkan operasi dari pemeliharaan: Bedakan konfirmasi alarm operator ruang kontrol dari persetujuan perintah kerja pemeliharaan.
- Audit aturan secara rutin: Tinjau kinerja pemicu otomatis setiap bulan dan hapus ambang yang menghasilkan notifikasi yang tidak dapat ditindaklanjuti.
- Perlakukan perangkat keras jaringan sebagai aset: Sertakan secara eksplisit switch yang dikelola, konverter media serat optik, dan pasangan server SCADA dalam daftar aset CMMS.
Berapa perkiraan laba atas investasi untuk pemeliharaan prediktif tingkat pengontrol?
Peralihan dari pemecahan masalah reaktif ke interval pemeliharaan terencana menghilangkan waktu henti darurat yang berbiaya tinggi. Persediaan suku cadang menjadi akurat dan berbasis data, sementara baseline diagnostik dari komisioning baru terintegrasi dengan lancar ke dalam catatan pemeliharaan historis.
Untuk menerapkannya dengan sukses, mulailah dengan memantau sepuluh node jaringan kritis atau koneksi I/O di seluruh fasilitas Anda, tetapkan tren baseline, lalu perluas kerangka kerja tersebut ke pengontrol lainnya.
Penulis: Chen Weiming adalah insinyur otomasi industri dengan pengalaman lebih dari 10 tahun di bidang PLC, DCS, dan sistem kontrol.


