
Prediktivno održavanje PLC i SCADA sistema: terenski vodič za inženjere
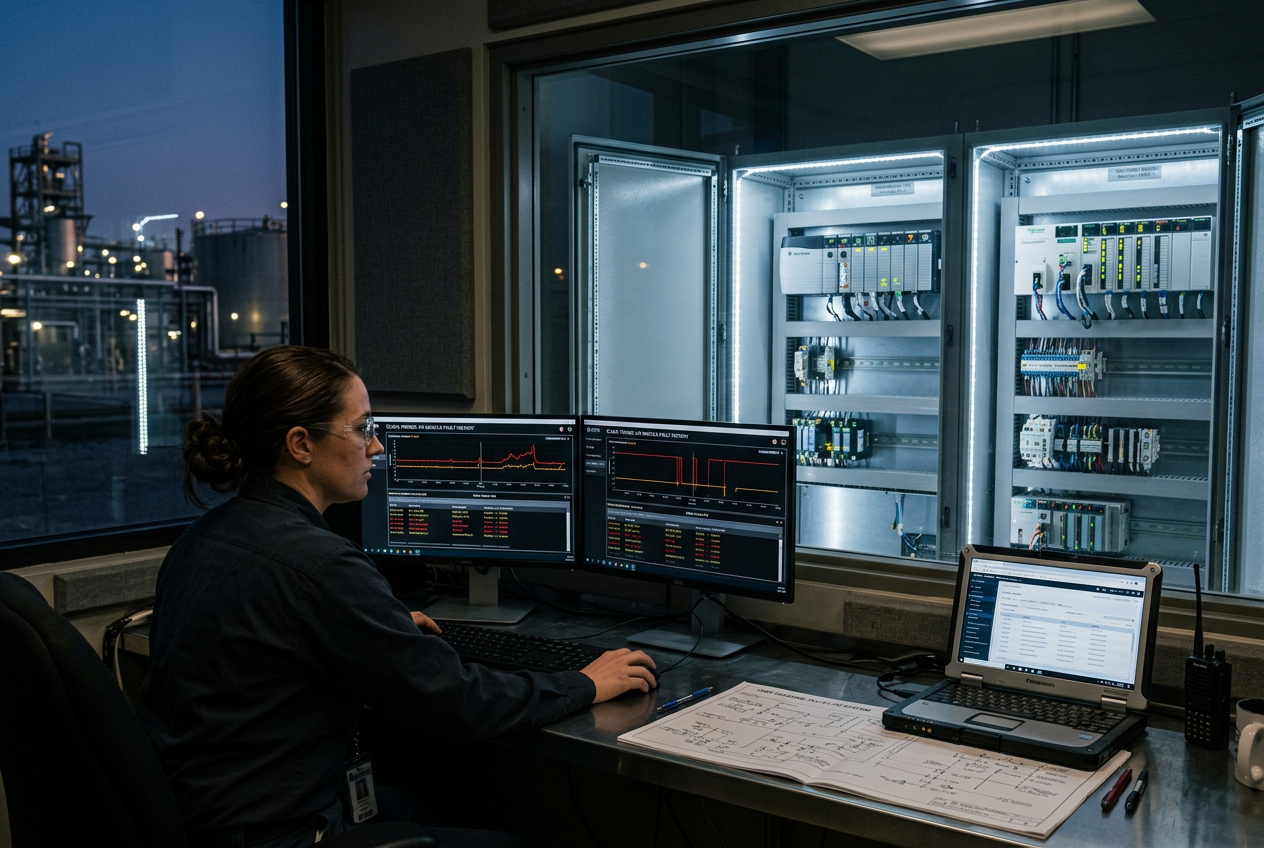
U savremenim industrijskim postrojenjima, sloj automatizacije retko otkazuje katastrofalno bez upozorenja. I/O modul se povremeno isključi jednom nedeljno ili udaljena komunikacija istekne dva puta po smeni. Proizvodnja se nastavlja bez prekida, ali se kritični signali upozorenja neprimetno gomilaju u dijagnostičkim baferima. Umesto uvođenja skupih dodatnih mreža senzora vibracija ili temperature, efikasno prediktivno održavanje počinje aktivnim praćenjem dijagnostičkih podataka koje vaši kontroleri i komunikacioni mostovi već objavljuju.
Zašto prediktivno održavanje treba da počne unutar vaših postojećih PLC kontrolera?
Kao što su stručnjaci iz industrije na sajtu InstrumentationTools nedavno istakli, PLC i SCADA dijagnostički registri sadrže rane pokazatelje kvarova mnogo pre nego što dođe do mehaničkog otkaza. Iskustvo sa terena pokazuje da se oprema za automatizaciju degradira neprimetno: tihi gubici paketa, ponovni pokušaji i greške bafera gomilaju se u memoriji kontrolera. Korišćenje ovih postojećih internih mernih podataka omogućava neposredno praćenje stanja bez ulaganja u redundantnu sekundarnu instrumentaciju.
Kako pratiti stanje EtherNet/IP mreže na Allen-Bradley ControlLogix sistemu?
Allen-Bradley ControlLogix arhitekture, zasnovane na kontrolerima visokih performansi kao što je Allen Bradley 1756-L85EP ControlLogix 5580 Process Controller Module, nude detaljan uvid u dijagnostiku putem GSV (Get System Value) instrukcija i izvornih veb interfejsa na mostovskim modulima kao što je Allen Bradley 1756-EN2T EtherNet/IP Communication Bridge Module.
-
Periodično očitavajte statusne reči: Izvršavajte periodične GSV instrukcije za upite oznaka
Module:StatusiModule:FaultInfou intervalima od jednog minuta. - Pratite brojače CIP veza: Koristite ugrađenu EN2T veb dijagnostiku za beleženje isteka vremena CIP veza, sa fokusom na određene grupe zahtevanog intervala paketa (RPI).
- Označite ponavljane prekide veze: Postavite logičke oznake kada se udaljeni uređaji, kao što su Flex I/O ili Point I/O adapteri, ponovo povežu više od tri puta tokom 24-časovnog ciklusa.
- Prosleđujte oznake kvaliteta sistemu SCADA: Prosleđujte izračunati status kvaliteta uređaja u SCADA istoričar zajedno sa operativnim procesnim oznakama.
Ovaj pristup ne zahteva dodatni hardver i prepoznaje propadanje neupravljanih svičeva, oštećenih priključnih kablova ili graničnih optičkih primopredajnika nedeljama pre nego što izazovu neočekivani zastoj linije.
Kako pratiti trend grešaka Modbus TCP komunikacije na Schneider M340 sistemu?
Schneider Electric Modicon arhitekture, uključujući Schneider Modicon M340 BMXP342000 Processor Module uparen sa namenskim interfejsima kao što je Schneider BMXNOC0401 M340 Ethernet Communication Module, beleže detaljnu statistiku stanja komunikacije po kanalu unutar sistema Unity Pro / EcoStruxure Control Expert.
-
Očitavajte sistemske reči: Očitavajte interne komunikacione statusne registre
%SWi brojače grešaka kanala u intervalima od pet minuta i upisujte ih u istoričar. - Analizirajte brzinu promene: Izračunajte stopu grešaka tokom vremena umesto praćenja kumulativnih brojeva, jer skokovi stope ukazuju na akutno propadanje komponente.
- Pratite Modbus kodove izuzetaka: Obratite posebnu pažnju na ponovljene odgovore Exception 03, koji često ukazuju na nepodudaranje registara nakon ažuriranja firmvera uređaja nezavisnih proizvođača.
- Povežite greške sa uslovima okoline: Prikažite skokove komunikacionih grešaka u odnosu na temperaturu u ormanu i vibracije mašine kako biste brzo locirali labave priključne kleme.
Filtriranje je ključno: izolovani izuzetak dnevno predstavlja uobičajeni komunikacioni šum, dok pedeset ponovljenih pokušaja na sat ukazuje na otkazivanje terenskog primopredajnika ili zasićenje mreže.
Kako proslediti prediktivna upozorenja u CMMS bez izazivanja zamora od alarma?
Ako svaki prolazni mrežni problem generiše nalog za održavanje, tehničari održavanja brzo postaju neosetljivi. Disciplinovana strategija kvalifikacije čuva poverenje tehničara:
- Zahtevajte ponavljanje stanja: Podesite pragove za pokretanje CMMS naloga tako da zahtevaju trajne probleme, kao što su tri prekinute sesije na čvoru u roku od 24 sata.
- Obogatite kontekst naloga: Automatski dodajte oznaku konkretnog sredstva, tačan dijagnostički kod greške i simptome opisane jednostavnim jezikom svakom radnom nalogu.
- Odvojite rad od održavanja: Potvrde alarma operatera u kontrolnoj sobi držite odvojeno od odobrenja radnih naloga za održavanje.
- Redovno proveravajte pravila: Mesečno pregledajte učinak automatizovanih okidača i ukinite pragove koji proizvode obaveštenja bez mogućnosti postupanja.
- Tretirajte mrežni hardver kao sredstva: Izričito uključite upravljane svičeve, optičke medijske konvertore i parove SCADA servera u registar sredstava CMMS sistema.
Kakav je očekivani povraćaj ulaganja u prediktivno održavanje na nivou kontrolera?
Prelazak sa reaktivnog otklanjanja problema na planirane intervale održavanja eliminiše skupe vanredne zastoje. Zalihe rezervnih delova postaju precizno zasnovane na podacima, a nove dijagnostičke početne vrednosti prilikom puštanja u rad neprimetno se integrišu u istorijske zapise o održavanju.
Da biste ovo uspešno sproveli, počnite praćenjem deset kritičnih mrežnih čvorova ili I/O prekida u svom postrojenju, utvrdite početne trendove i proširite okvir na preostale kontrolere.
Autor: Chen Weiming je inženjer industrijske automatizacije sa više od 10 godina iskustva u PLC, DCS i upravljačkim sistemima.


