
Прогнозное техническое обслуживание систем ПЛК и SCADA: практическое руководство инженера
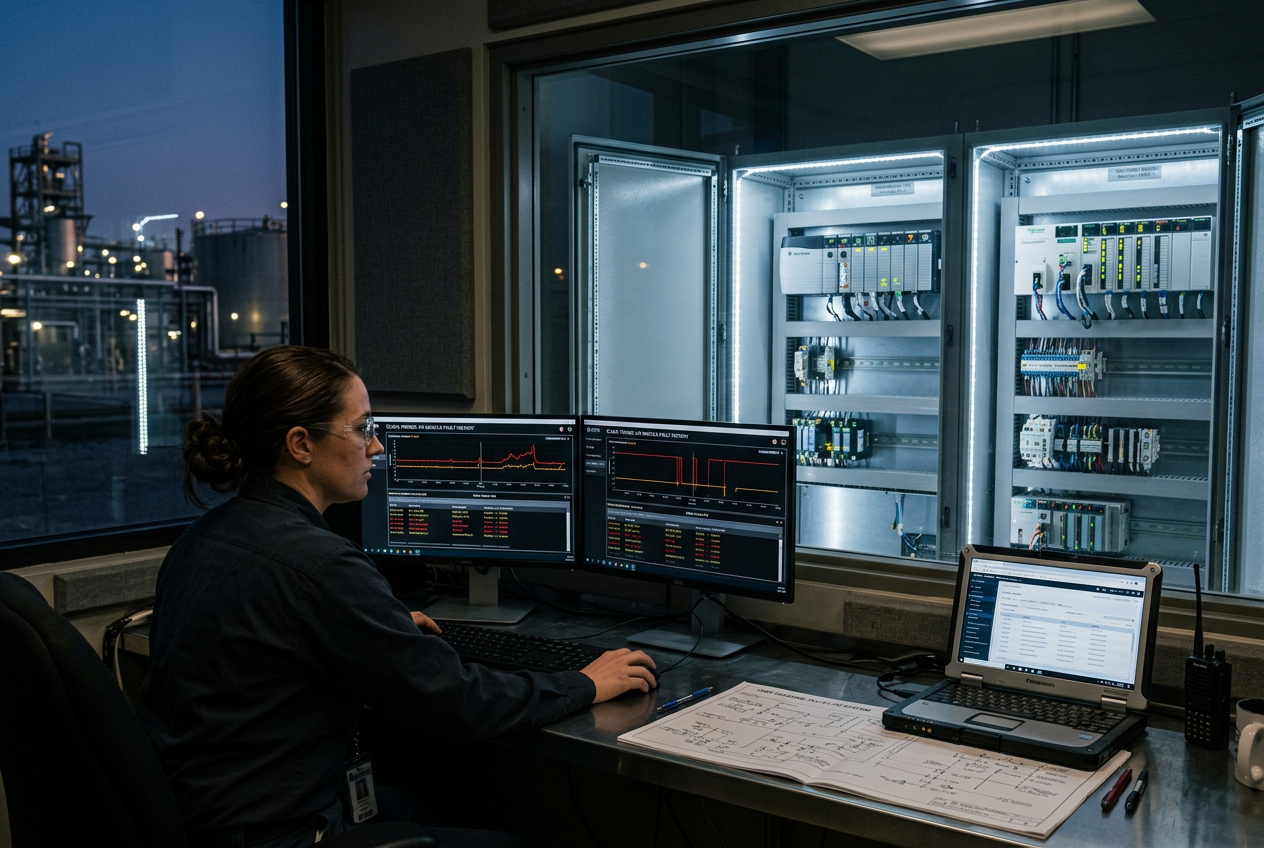
На современных промышленных предприятиях уровень автоматизации редко выходит из строя катастрофически и без предупреждения. Модуль ввода-вывода раз в неделю периодически отключается от сети, или удалённое соединение дважды за смену не отвечает по тайм-ауту. Производство продолжает работать без перебоев, но критические предупреждающие сигналы незаметно накапливаются в диагностических буферах. Вместо внедрения дорогостоящих дополнительных сетей датчиков вибрации или температуры эффективное прогнозное обслуживание начинается с активного анализа диагностических данных, которые ваши контроллеры и коммуникационные мосты уже публикуют.
Почему прогнозное обслуживание следует начинать внутри уже существующих ПЛК?
Как недавно отметили отраслевые эксперты InstrumentationTools, диагностические регистры ПЛК и SCADA содержат ранние признаки неисправностей задолго до механического отказа. Практический опыт показывает, что оборудование автоматизации деградирует незаметно: скрытые потери пакетов, повторные попытки и ошибки буфера накапливаются в памяти контроллера. Использование этих существующих внутренних показателей обеспечивает немедленный контроль состояния без вложений в дублирующие вторичные средства измерения.
Как контролировать состояние EtherNet/IP в Allen-Bradley ControlLogix?
Архитектуры Allen-Bradley ControlLogix, основанные на высокопроизводительных контроллерах, таких как процессорный модуль Allen Bradley 1756-L85EP ControlLogix 5580, обеспечивают глубокую диагностическую видимость с помощью инструкций GSV (Get System Value) и встроенных веб-интерфейсов коммуникационных мостов, таких как коммуникационный мостовой модуль Allen Bradley 1756-EN2T EtherNet/IP.
-
Периодически считывайте слова состояния: выполняйте периодические инструкции GSV для опроса тегов
Module:StatusиModule:FaultInfoс интервалом в одну минуту. - Отслеживайте счётчики CIP-соединений: используйте встроенную веб-диагностику EN2T для регистрации тайм-аутов CIP-соединений, уделяя особое внимание определённым группам Requested Packet Interval (RPI).
- Фиксируйте повторяющиеся разрывы связи: устанавливайте логические флаги, когда удалённые устройства, например адаптеры Flex I/O или Point I/O, переподключаются более трёх раз за 24-часовой цикл.
- Передавайте теги качества в SCADA: отправляйте рассчитанный статус качества устройства в архиватор SCADA вместе с тегами рабочего процесса.
Этот подход не требует дополнительного оборудования и позволяет выявить ухудшение состояния неуправляемых коммутаторов, повреждённых коммутационных шнуров или работающих на пределе оптических трансиверов за несколько недель до того, как они вызовут неожиданный простой линии.
Как отслеживать динамику ошибок связи Modbus TCP в Schneider M340?
Архитектуры Schneider Electric Modicon, включая процессорный модуль Schneider Modicon M340 BMXP342000 в сочетании со специализированными интерфейсами, такими как коммуникационный модуль Ethernet Schneider BMXNOC0401 M340, регистрируют подробную статистику состояния связи по каждому каналу в Unity Pro / EcoStruxure Control Expert.
-
Опрос системных слов: с интервалом в пять минут передавайте во временной архив внутренние регистры состояния связи
%SWи счётчики ошибок каналов. - Анализируйте скорость изменения: рассчитывайте частоту ошибок во времени, а не отслеживайте только накопительные значения, поскольку скачки частоты выявляют острое ухудшение состояния компонентов.
- Отслеживайте коды исключений Modbus: обращайте особое внимание на повторяющиеся ответы Exception 03, которые часто указывают на несоответствие регистров после обновления прошивки устройств сторонних производителей.
- Сопоставляйте ошибки с условиями окружающей среды: сопоставляйте всплески ошибок связи с температурой внутри шкафа и вибрацией машины, чтобы быстро находить ослабленные клеммы проводки.
Фильтрация имеет ключевое значение: единичное исключение в день является обычным коммуникационным шумом, тогда как пятьдесят повторных попыток в час указывают на неисправный полевой трансивер или перегрузку сети.
Как передавать прогнозные предупреждения в CMMS, не вызывая усталость от сигналов?
Если каждый кратковременный сбой сети создаёт заявку на обслуживание, технические специалисты быстро перестают реагировать на такие уведомления. Продуманная стратегия квалификации сохраняет доверие специалистов:
- Требуйте повторения состояния: задавайте пороги запуска CMMS, требующие устойчивого проявления проблемы, например трёх разрывов сеанса на одном узле в течение 24 часов.
- Дополняйте заявку контекстом: автоматически добавляйте к каждому заказу на выполнение работ конкретный тег актива, точный код диагностической ошибки и описание симптомов понятным языком.
- Разделяйте эксплуатацию и обслуживание: не объединяйте подтверждения тревог операторами диспетчерской с отметками о выполнении заказов на обслуживание.
- Регулярно проверяйте правила: ежемесячно анализируйте эффективность автоматических триггеров и отменяйте пороги, создающие уведомления, не требующие действий.
- Считайте сетевое оборудование активами: явно включайте управляемые коммутаторы, оптические медиаконвертеры и пары серверов SCADA в реестр активов CMMS.
Какова ожидаемая окупаемость прогнозного обслуживания на уровне контроллеров?
Переход от устранения неисправностей по факту к плановым интервалам обслуживания устраняет дорогостоящие аварийные простои. Запасы запасных частей формируются на основе точных данных, а новые диагностические базовые показатели, полученные при вводе в эксплуатацию, беспрепятственно интегрируются в исторические записи об обслуживании.
Для успешного внедрения начните с мониторинга десяти критически важных сетевых узлов или подключений ввода-вывода на предприятии, сформируйте базовые тренды и распространите эту систему на остальные контроллеры.
Автор: Чэнь Вэймин - инженер по промышленной автоматизации с более чем 10-летним опытом работы с ПЛК, DCS и системами управления.


