
Guida pratica dell'ingegnere alla manutenzione predittiva per sistemi PLC e SCADA
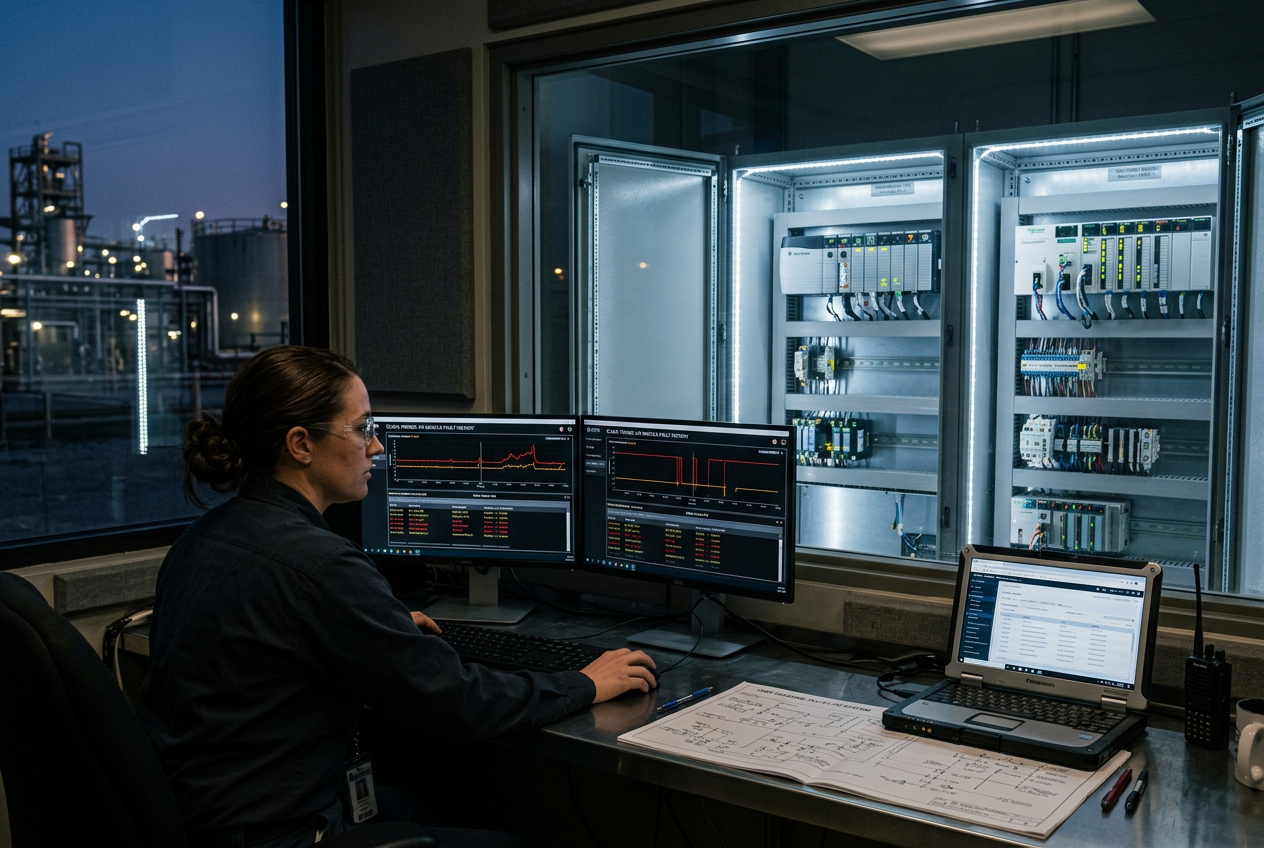
Negli impianti industriali moderni, il livello di automazione raramente si guasta in modo catastrofico senza preavviso. Un modulo I/O si disconnette a intermittenza una volta alla settimana oppure una perdita di comunicazione remota va in timeout due volte per turno. La produzione continua senza interruzioni, ma i segnali di avvertimento critici si accumulano silenziosamente nei buffer diagnostici. Anziché implementare costose reti supplementari di sensori di vibrazione o temperatura, una manutenzione predittiva efficace inizia ascoltando attivamente i dati diagnostici che i controller e i bridge di comunicazione già pubblicano.
Perché la manutenzione predittiva dovrebbe iniziare all'interno dei controller PLC esistenti?
Come hanno recentemente evidenziato gli esperti del settore di InstrumentationTools, i registri diagnostici di PLC e SCADA contengono segnali precoci di guasto molto prima che si verifichi un guasto meccanico. L'esperienza sul campo dimostra che le apparecchiature di automazione si degradano silenziosamente: perdite di pacchetti, ritrasmissioni ed errori dei buffer si accumulano nella memoria del controller. Attingere a queste metriche interne esistenti consente di monitorare immediatamente le condizioni senza investire in strumentazione secondaria ridondante.
Come si monitora lo stato di EtherNet/IP su Allen-Bradley ControlLogix?
Le architetture Allen-Bradley ControlLogix, alimentate da controller ad alte prestazioni come il modulo controller di processo Allen Bradley 1756-L85EP ControlLogix 5580, offrono una visibilità diagnostica approfondita tramite le istruzioni GSV (Get System Value) e le interfacce web native presenti su moduli bridge come il modulo bridge di comunicazione Allen Bradley 1756-EN2T EtherNet/IP.
-
Leggere periodicamente le parole di stato: eseguire istruzioni GSV periodiche per interrogare i tag
Module:StatuseModule:FaultInfoa intervalli di un minuto. - Monitorare i contatori delle connessioni CIP: utilizzare la diagnostica web integrata dell'EN2T per registrare i timeout delle connessioni CIP, concentrandosi su specifici gruppi di Requested Packet Interval (RPI).
- Segnalare le perdite di collegamento ricorrenti: impostare flag logici quando i dispositivi remoti, come gli adattatori Flex I/O o Point I/O, si riconnettono più di tre volte nell'arco di 24 ore.
- Inviare i tag di qualità al sistema SCADA: trasferire lo stato di qualità calcolato dei dispositivi allo storico SCADA insieme ai tag dei processi operativi.
Questo approccio non richiede hardware ausiliario e identifica switch non gestiti in fase di deterioramento, cavi patch danneggiati o ricetrasmettitori in fibra al limite delle prestazioni settimane prima che provochino un'interruzione imprevista della linea.
Come si monitorano nel tempo gli errori di comunicazione Modbus TCP su Schneider M340?
Le architetture Schneider Electric Modicon, incluso il modulo processore Schneider Modicon M340 BMXP342000 abbinato a interfacce dedicate come il modulo di comunicazione Ethernet Schneider BMXNOC0401 M340, registrano statistiche dettagliate sullo stato della comunicazione per ogni canale all'interno di Unity Pro / EcoStruxure Control Expert.
-
Interrogare le parole di sistema: interrogare i registri interni di stato della comunicazione
%SWe i contatori degli errori dei canali a intervalli di cinque minuti, memorizzando i dati nello storico. - Analizzare il tasso di variazione: calcolare il tasso di errore nel tempo anziché monitorare i conteggi cumulativi, poiché i picchi del tasso rivelano un deterioramento acuto dei componenti.
- Monitorare i codici di eccezione Modbus: prestare particolare attenzione alle risposte ripetute Exception 03, che spesso indicano incompatibilità nei registri dopo gli aggiornamenti del firmware di dispositivi di terze parti.
- Correlare gli errori con le condizioni ambientali: tracciare i picchi degli errori di comunicazione rispetto alla temperatura ambiente dell'armadio e alle vibrazioni della macchina per individuare rapidamente i terminali di cablaggio allentati.
Il filtraggio è fondamentale: un'eccezione isolata al giorno rientra nel normale rumore della comunicazione, mentre cinquanta ritrasmissioni all'ora indicano un ricetrasmettitore di campo in avaria o una saturazione della rete.
Come si possono inviare gli avvisi predittivi a un CMMS senza causare assuefazione agli allarmi?
Se ogni anomalia transitoria della rete genera una richiesta di manutenzione, i tecnici si desensibilizzano rapidamente. Una strategia disciplinata di qualificazione preserva la fiducia dei tecnici:
- Richiedere la ripetizione della condizione: impostare le soglie di attivazione del CMMS in modo da richiedere problemi persistenti, come tre sessioni interrotte su un nodo entro 24 ore.
- Arricchire il contesto della richiesta: aggiungere automaticamente a ogni ordine di lavoro il tag specifico dell'asset, il codice di errore diagnostico esatto e i sintomi descritti in linguaggio semplice.
- Separare l'operatività dalla manutenzione: mantenere distinti i riconoscimenti degli allarmi da parte degli operatori della sala di controllo dalle approvazioni degli ordini di lavoro di manutenzione.
- Verificare regolarmente le regole: riesaminare mensilmente le prestazioni degli attivatori automatici e ritirare le soglie che producono notifiche prive di valore operativo.
- Trattare l'hardware di rete come asset: includere esplicitamente nel registro degli asset del CMMS gli switch gestiti, i convertitori di supporto per fibra e le coppie di server SCADA.
Qual è il ritorno sull'investimento previsto per la manutenzione predittiva a livello di controller?
Il passaggio dalla risoluzione reattiva dei problemi a intervalli di manutenzione pianificati elimina i costosi tempi di fermo di emergenza. Le scorte di ricambi diventano accurate e basate sui dati, mentre le nuove linee di base diagnostiche di messa in servizio si integrano perfettamente nei registri storici di manutenzione.
Per implementare con successo questo approccio, iniziare monitorando dieci nodi di rete critici o disconnessioni I/O nella propria struttura, stabilire le tendenze di riferimento ed estendere il modello agli altri controller.
Autore: Chen Weiming è un ingegnere dell'automazione industriale con oltre 10 anni di esperienza in PLC, DCS e sistemi di controllo.


