
Phoenix Contact et Bachmann sur PROFINET : des diagnostics avancés qui mettent fin aux déconnexions inexpliquées
Sous-titre : Noms des appareils, vérifications de topologie LLDP et anneaux MRP, expliqués étape par étape à partir d’un réseau réel de ligne de conditionnement.
Pourquoi les appareils PROFINET se déconnectent-ils alors que les vérifications de base et les LED semblent normales ?
Considérons une ligne de conditionnement où une machine d’emballage perd sa station codeur deux fois par équipe. L’appareil récupère de lui-même, les LED du panneau sont vertes et l’adresse IP n’entre en conflit avec aucune autre. Le dépannage de base s’arrête ici, mais les déconnexions intermittentes proviennent rarement uniquement de câbles défectueux ou de conflits d’adresses. La plupart des causes profondes cachées résident dans les conventions de nommage des appareils PROFINET, les mécanismes de détection de topologie ou les décalages de temporisation de la redondance. Dans les lignes de conditionnement à grande vitesse utilisant des interfaces codeur comme le module d’interface codeur Bachmann ISI202, la résolution de ces déclenchements mystérieux exige d’aller au-delà des vérifications au multimètre et de passer aux diagnostics au niveau du protocole.
Pourquoi PROFINET s’appuie-t-il sur les noms d’appareils plutôt que sur les adresses IP ?
Contrairement aux réseaux TCP/IP standard, PROFINET identifie principalement un appareil IO par son nom de station unique et secondairement par son adresse IP. Lorsqu’un contrôleur automate démarre, il utilise le protocole Discovery and Basic Configuration Protocol (DCP) pour analyser le sous-réseau et associer les appareils IO par leur nom, même si un appareil ne dispose pas d’une configuration IP valide. Un nom de station en double, mal orthographié ou manquant interrompt complètement la communication, quelle que soit l’état physique des câbles. À l’inverse, si le nom de station correspond à la configuration matérielle, le contrôleur peut réattribuer automatiquement l’adresse IP correcte. Vérifiez toujours en ligne les associations de noms DCP avant de remplacer le matériel.
Quels paramètres d’interface empêchent les délais d’attente de la communication acyclique ?
La mise en service standard néglige souvent trois paramètres d’interface essentiels qui régissent le comportement en cas de défaillance sous contrainte :
- Maintenir la communication PROFINET IO en cas de délai d’attente d’un enregistrement de données : Désactivé par défaut. Lorsque les lectures de paramètres acycliques échouent ou dépassent le délai d’attente, l’activation de cette option maintient les données de processus cycliques actives au lieu de couper toute la connexion.
- Prendre en charge le remplacement d’un appareil sans support d’échange : Activé par défaut pour permettre le remplacement transparent du matériel sans ordinateur portable de programmation grâce à la détection des voisins LLDP. Vérifiez que cette option reste activée.
- Mode LLDP IEC V2.2 : Active la détection physique continue des voisins et émet des alertes lorsque des câbles sont branchés sur les mauvais ports. Contrôlez ce paramètre pendant la mise en service afin de détecter rapidement les erreurs de câblage.
Comment empêcher l’inondation du réseau dans un anneau redondant MRP ?
Le Media Redundancy Protocol (MRP) assure une communication ininterrompue en maintenant un port bloqué en fonctionnement normal et en le débloquant en environ 200 millisecondes si une rupture se produit. Toutefois, un anneau MRP ne fonctionne correctement que lorsqu’un seul commutateur agit comme gestionnaire de redondance (MRM), tandis que tous les autres nœuds fonctionnent comme clients de redondance (MRC). Plusieurs gestionnaires provoquent des tempêtes de diffusion et une inondation de paquets, tandis qu’une absence totale de gestionnaire désactive la récupération de l’anneau. Pour les nœuds d’automatisation critiques, associer la redondance réseau à une redondance matérielle de l’alimentation, telle qu’un module de redondance Phoenix Contact, offre une protection complète à haute disponibilité.
Quelles sont les causes de la gigue et de la perte de synchronisation dans les réseaux PROFINET RT et IRT ?
PROFINET Real-Time (RT) transmet directement les trames Ethernet au niveau 2 afin d’éviter les délais de traitement TCP/UDP. Isochronous Real-Time (IRT) intègre la synchronisation des horloges via le Precision Time Protocol (PTP) IEEE 1588, ce qui permet d’atteindre des temps de cycle inférieurs à 250 microsecondes. Toutefois, l’IRT est sans tolérance : un nœud non synchronisé, un commutateur non administrable sur le chemin ou un domaine temporel incompatible perturbe le calendrier déterministe. Surveillez régulièrement les statistiques des ports, les taux de perte de paquets et les erreurs CRC sur les commutateurs administrables au lieu d’estimer l’utilisation de la bande passante du réseau.
Comment les commutateurs Phoenix Contact et les contrôleurs Bachmann M1 localisent-ils les défauts matériels ?
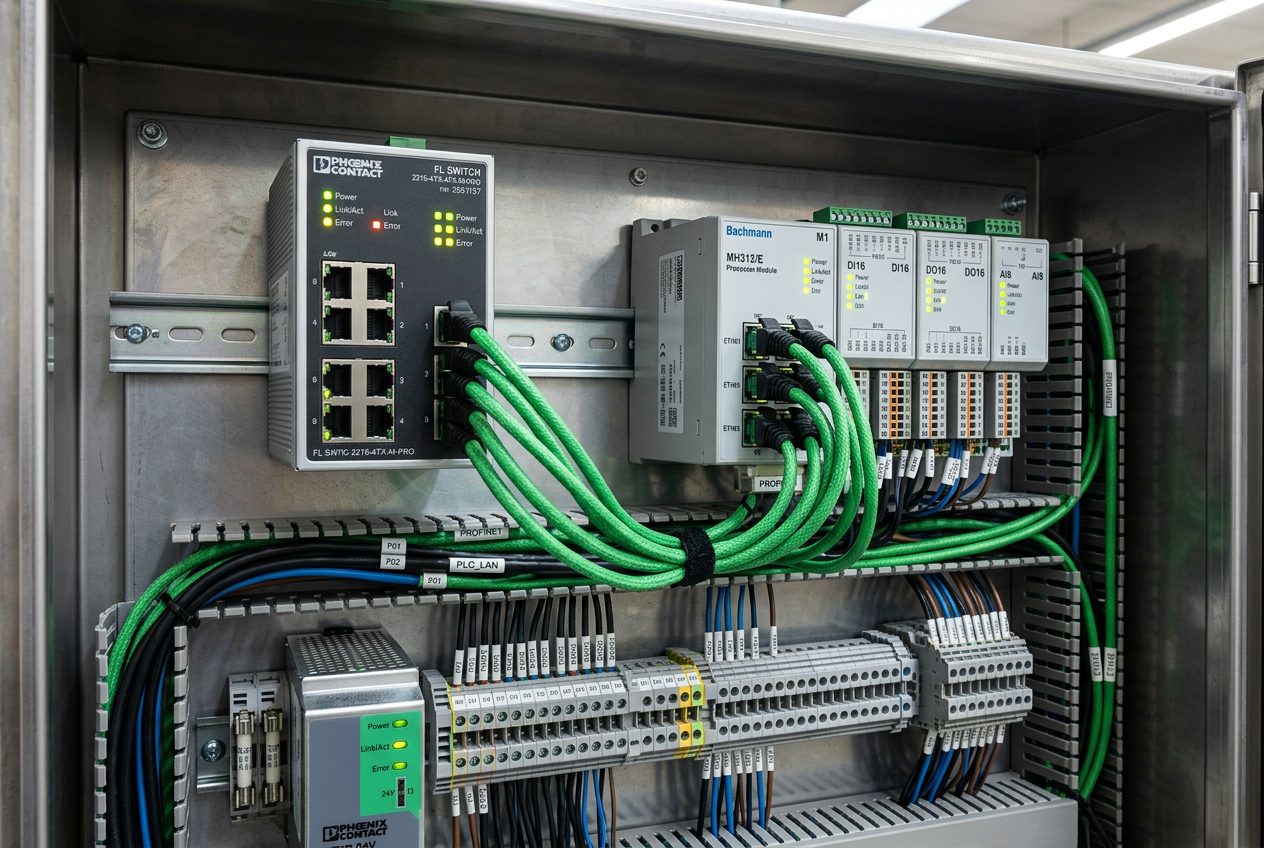
Dans les architectures modernes de conditionnement, les commutateurs administrables et les contrôleurs avancés travaillent ensemble pour localiser les défaillances intermittentes. Les commutateurs administrables Phoenix Contact fournissent des diagnostics complets des ports et révèlent les pics des compteurs CRC, indicateurs de câbles écrasés ou d’interférences électriques. Parallèlement, les contrôleurs tels que le module contrôleur Bachmann MPC240/K M1 fournissent des diagnostics PROFINET étendus en texte clair dans le logiciel d’ingénierie. Lorsque la synchronisation IRT est interrompue, la pile de diagnostic Bachmann signale instantanément l’unité esclave exacte et le code d’erreur. Pour les architectures multi-constructeurs communiquant avec des passerelles DCS ou des appareils comme un module d’interface IO PROFINET ABB CI871, le maintien de fichiers de configuration GSDML correspondants garantit la cohérence du protocole dans toute l’installation.
Quelle est la séquence de diagnostic recommandée en 7 étapes pour les déconnexions intermittentes ?
Pour analyser les déconnexions réseau difficiles à isoler, suivez cette procédure de dépannage structurée :
- Étape 1 : Vérifiez en ligne les noms des stations et des appareils, puis confirmez l’affectation au sous-réseau PN/IE de chaque appareil IO.
- Étape 2 : Contrôlez les trois options d’interface essentielles (délai d’attente d’un enregistrement de données, remplacement de l’appareil et mode LLDP).
- Étape 3 : Vérifiez les rôles des appareils dans l’anneau MRP afin de confirmer qu’un seul gestionnaire est configuré dans une topologie en anneau fermé.
- Étape 4 : Examinez les tables des voisins LLDP et comparez-les au schéma de topologie du réseau tel qu’il a été construit.
- Étape 5 : Inspectez les statistiques d’erreurs des ports des commutateurs pour détecter les erreurs CRC, les rejets de trames et les pics inattendus de bande passante.
- Étape 6 : Confirmez que la description d’appareil GSDML installée correspond à la révision du micrologiciel matériel.
- Étape 7 : Capturez les enregistrements de diagnostic étendus directement depuis le tampon de diagnostic du contrôleur après chaque événement de déconnexion.
Comment prévenir les futures déconnexions PROFINET sur le site de production ?
Transformer les déconnexions mystérieuses en données exploitables exige une discipline stricte au niveau du protocole. Considérez le nommage des appareils DCP comme l’identité réseau principale, imposez une topologie d’anneau MRP à gestionnaire unique et vérifiez les tables des voisins LLDP par rapport aux plans de l’installation. L’utilisation de matériel offrant une transparence intégrée des diagnostics, comme les commutateurs administrables Phoenix Contact et les systèmes de contrôle Bachmann M1, transforme des heures de recherche de câbles en quelques minutes de dépannage ciblé.
Auteur : Zhiqiang Li est ingénieur en automatisation industrielle et possède plus de 10 ans d’expérience dans les automates, les systèmes DCS et les systèmes de contrôle.


