

OPC-Server verbunden, aber Tags eingefroren: Ein Praxisleitfaden für Honeywell und Emerson Ovation
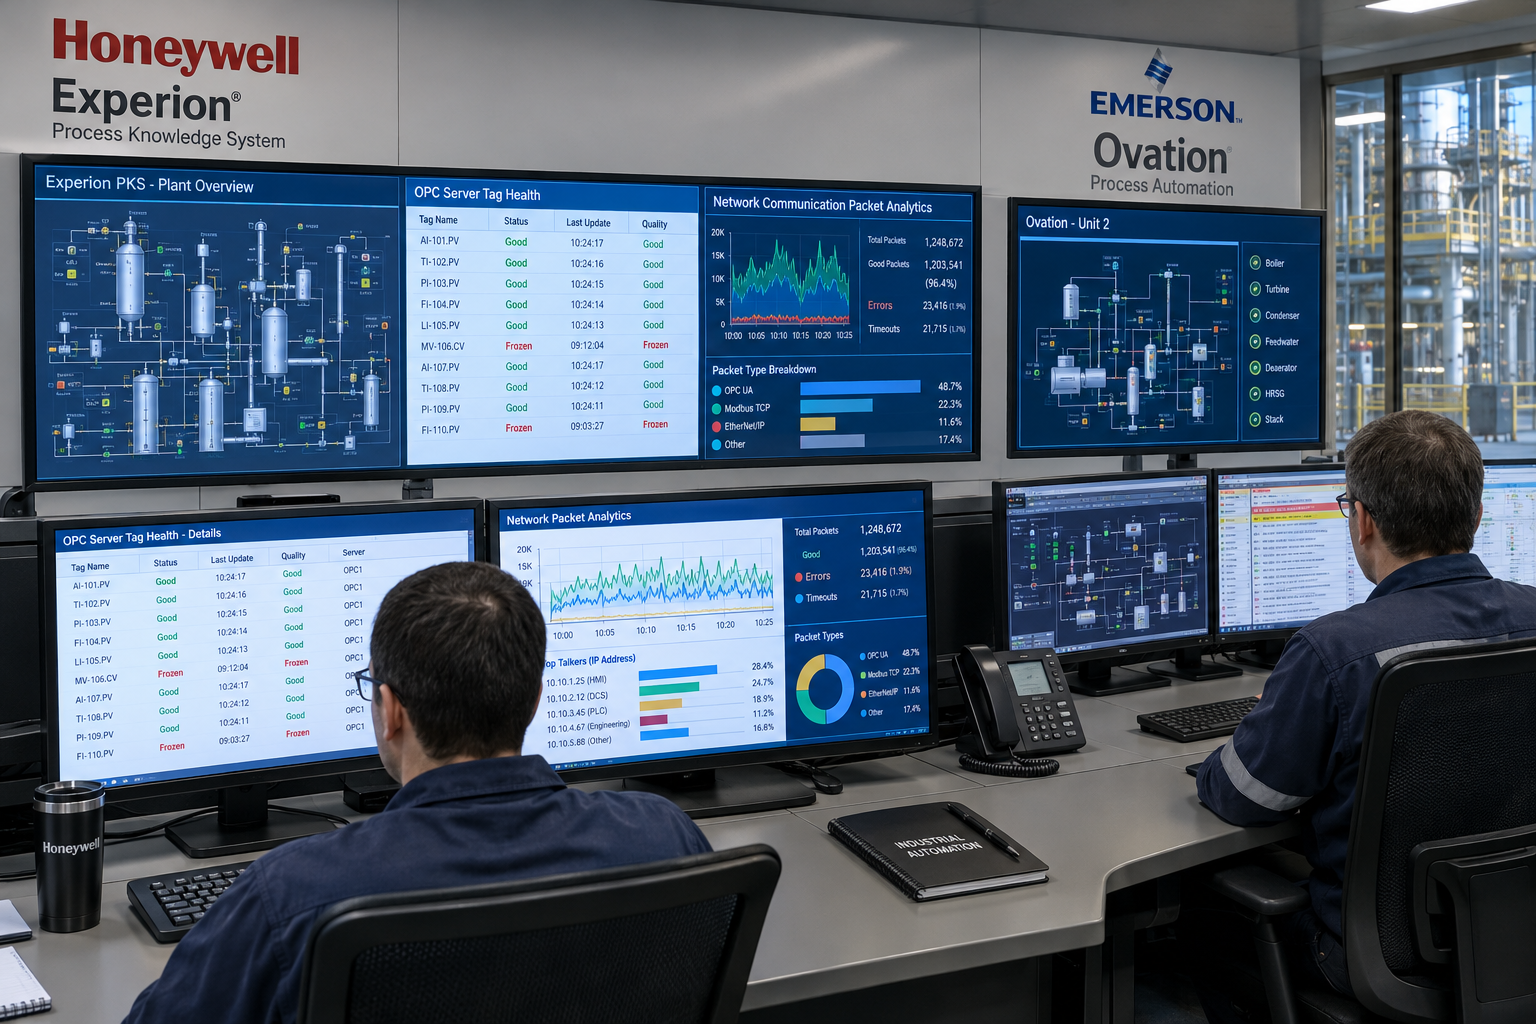
Ein OPC-Verbindungssymbol mit einem durchgehend grünen Status ist einer der trügerischsten Indikatoren in der industriellen Automatisierung. Wartungstechniker und Regelungstechniker stellen häufig fest, dass die OPC-Client-Anwendung zwar „Verbunden“ meldet, die Live-Prozessvariablen jedoch vollständig eingefroren bleiben. Bevor Sie den Server aus- und wieder einschalten oder den Netzwerk-Switch neu starten, müssen Sie erkennen, dass dieses Symptom nur selten auf einen physischen Kabelfehler zurückzuführen ist - fast immer handelt es sich um ein Konfigurations-, Abfrage- oder Datenqualitätsproblem.
Dieser Leitfaden zur Fehlersuche überträgt Erfahrungen aus der Praxis in messbare Prüfungen für Ingenieure, die OPC-DA- und OPC-UA-Schnittstellen in verteilten Steuerungsarchitekturen von Honeywell Experion (LOPC/ROPC) und Emerson Ovation verwalten.
Warum frieren OPC-Tags ein, während der Serververbindungsstatus grün bleibt?
Die kurze Antwort liegt in der Unterscheidung zwischen Verbindungsstatus und Datenqualität. Ein OPC-Server kann eine vollkommen intakte Socket-Verbindung zu einem Engineering-Client aufrechterhalten. Wenn sich jedoch die zugrunde liegende SPS- oder DCS-Tag-Adresse geändert hat, meldet der Server lediglich den zuletzt bekannten Wert mit veralteter Qualität.
Während Anlagenstillständen und Inbetriebnahmephasen werden SPS-Logikdateien fortlaufend neu kompiliert: Speicherdatenblöcke werden neu organisiert, Symbolnamen ändern sich und Array-Grenzen verschieben sich. Wenn der OPC-Item-Namensraum nicht mit der Symboldatenbank des Controllers synchronisiert ist, liest der Treiber weiterhin eine verwaiste Adresse. Bei der Diagnose analoger Regelkreise, die über Hardware wie das analoge Eingangmodul Emerson Ovation 5X00605G01 oder über Abschlussbaugruppen wie die analoge Eingangs-Abschlussbaugruppe Honeywell 8C-TAID61 verdrahtet sind, exportieren Sie stets die OPC-Tag-Liste als CSV-Datei und vergleichen Sie die Tag-Syntax mit der Datenbank des aktiven Controllers.
Wie überlasten Abonnementraten und Scan-Klassen die Kommunikationstreiber?
Kann eine zu aggressive Aktualisierungsrate Ihre Tags einfrieren? Absolut. Wenn ein OPC-Client für Tausende von Tags ein Aktualisierungsintervall von 100 ms anfordert, der Controller-Prozessor oder das Kommunikations-Gateway jedoch 250 ms für die Bearbeitung eines Anforderungszyklus benötigt, läuft die Kommunikationswarteschlange über. Der Treiber verwirft eingehende Frames, wodurch sich einige Tag-Gruppen unregelmäßig aktualisieren, während andere vollständig blockieren.
Auf Emerson-Ovation-Datenservern und Honeywell-Experion-ROPC-Knoten besteht die Lösung in einer strikten Trennung der Scan-Klassen:
- Schnelle Gruppe (100–250 ms): Ausschließlich für kritische Sicherheitsregelkreise und schnell reagierende Verriegelungen der Regelung reservieren.
- Standardgruppe (500 ms – 1 s): Allgemeine digitale Eingänge zuweisen, wie sie beispielsweise vom digitalen Eingangsmodul Emerson Ovation 5X00846G01 überwacht werden.
- Langsame Gruppe (2–5 s): Langsam veränderliche Prozessparameter wie Temperatur-RTD-Kanäle, Umgebungswerte und nicht kritische Tankfüllstände hierher verschieben.
Die Überwachung der Tiefe der Anforderungswarteschlange in Ihrem Kommunikationstreiber zeigt sofort, ob eine überlastete Abfragerate den Datendurchsatz beeinträchtigt.
Könnten Totband und Ereignisfilterung Änderungen von Live-Werten unbemerkt verbergen?
Eine weitere häufige Ursache für das vermeintliche „Einfrieren“ ist eine aggressive Totbandfilterung. OPC-DA- und OPC-UA-Server verwenden Totbandschwellen, um eine durch elektrisches Rauschen verursachte Überlastung des Netzwerks zu verhindern. Wenn jedoch ein analoger Kanal bei einem Messumformer von 0–5000 kPa auf ein Totband von 0,5 % eingestellt ist, löst eine Prozessschwankung von weniger als 25 kPa niemals ein OPC-Datenänderungsereignis aus. Die Client-Anzeige zeigt eine stationäre Nulllinie und erweckt den Eindruck eines Kommunikationsverlusts.
Prüfen Sie, ob das Totband als absoluter Wert oder als Prozentwert konfiguriert ist. Stellen Sie bei empfindlichen Eingängen - etwa bei Temperaturfühlern, die an ein Emerson-Ovation-RTD-Eingangsmodul (5X00119G02) angeschlossen sind - das Totband auf null oder passen Sie es exakt an die physikalische Auflösung des Sensors an. Behalten Sie moderate Totbänder nur bei naturgemäß verrauschten analogen Regelkreisen bei, bei denen Rohschwankungen andernfalls die Datenbankhistorianer überlasten würden.
Wann verursachen Gerätegruppen-Timeouts, veraltete Caches und Ethernet-Fragmentierung Einfrierungen?
Wenn eine ganze Gruppe von Tags einfriert, während andere weiterhin normal aktualisiert werden, liegt der Fehler typischerweise an einer von drei architektonischen Engpässen:
- Falsche Gruppenzuordnung: Eine falsche Steckplatznummer, Rack-ID oder IP-Adresse unterbricht die Kommunikation zu einem gesamten Teil-Rack, während andere Controller-Gruppen unbeeinträchtigt bleiben.
- Veralteter interner Treiber-Cache: Wenn Client-Anwendungen direkt aus dem OPC-Server-Cache statt aus dem physischen Gerät lesen und der Hintergrund-Abfrage-Thread eine unbehandelte Ausnahme erfährt, lesen die Clients kontinuierlich veraltete Cache-Daten, ohne eine Trennung zu melden. Dedizierte Kommunikationsbrücken wie die universelle Sicherheitsschnittstelle Honeywell FC-USI-0002 erfordern eine aktive Diagnoseüberwachung, um die Integrität des Treiber-Caches sicherzustellen.
- Fragmentierung von Ethernet-Paketen: Große Sammel-Leseanforderungen können auf mehrere TCP/IP-Frames aufgeteilt werden. In ausgelasteten Prozesssteuerungsnetzwerken führt bereits ein einziges verlorenes Fragment dazu, dass der Treiber den gesamten Datenblock verwirft, was zu periodischen oder anhaltenden Tag-Ausfällen führt. Begrenzen Sie die maximale Anzahl von Items pro Lesevorgang und isolieren Sie den Steuerungsverkehr in dedizierten VLANs.
Welche bewährte Vorgehensweise wird zur Wiederherstellung der Live-Datenqualität empfohlen?
Um eingefrorene Tags zu beseitigen und robuste Daten für den Anlagenhistorian sicherzustellen:
- Betrachten Sie einen grünen Verbindungsstatus niemals als Beweis für Live-Daten; überprüfen Sie stets den zeitlichen Fortschritt der einzelnen Tag-Zeitstempel und die Qualitätsbits (Good / Bad / Uncertain).
- Prüfen Sie die Totbandeinstellungen und stellen Sie sicher, dass die Scan-Klassen die Verarbeitungskapazität des Controllers berücksichtigen.
- Implementieren Sie ein automatisiertes Watchdog-Skript oder ein Heartbeat-Tag, das serverseitige Zeitstempel mit den Systemuhren auf Client-Seite vergleicht.
- Stellen Sie bei einer Neukonfiguration der Tags das Live-Polling Gruppe für Gruppe wieder her und beobachten Sie die Trends während einer vollständigen Betriebsschicht, bevor Sie die Konfiguration freigeben.
Über den Autor: Lu Jianhong ist Ingenieur für industrielle Automatisierung und verfügt über mehr als 10 Jahre praktische Erfahrung in den Bereichen SPS, DCS, SCADA und Integration von Steuerungssystemen.


